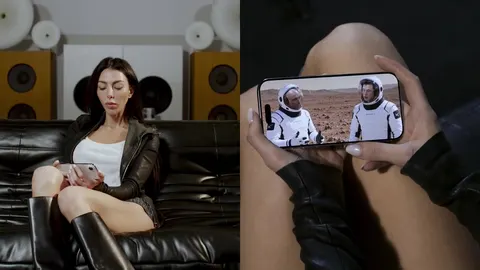
ACTx486:把一期现成播客,变成能插话、能改剧情的视频
ACTx486 拿一期现成播客做研究演示:观众看到一半可以插话,画面里的人接着解释、改变场景,再回到原节目。文中 12 段视频配有中英双语字幕,也能看出它离实时互动还有多远。
平时看视频,你只能暂停、快进、拖进度条。视频里的人说了一句你没听懂的话,你没法当场追问;你想知道「这事跟我有什么关系」,视频也不会回答你。
ACTx486 是研究者 Karina Nguyen 和交互设计师 Jakub Zegzulka 做的一段概念演示。他们拿《乔·罗根体验》里埃隆·马斯克做嘉宾的一期节目做底子:你看到一半点一下屏幕提问,画面里的人会回应;答完,节目从刚才停下的地方继续。
先看完整演示。观众 Lia 用手机看节目,中途问喷火器怎么工作,又让马斯克拿出星舰、带她去火星。画面上方的 REAL(原片) 和 ARTIFICIAL(生成) 标签,会随片段切换。
生成片段借用了马斯克和乔的脸与声音,里面的新台词并非他们本人所说;项目也与这档节目及主持人无关。
为什么是「改造一段现成视频」,而不是再做一个聊天框
现在的生成式 AI 几乎都从一个空白输入框开始:你想要什么,得自己想清楚、自己写出来。问题在于:可能性是无限的,负担却全压在用户身上。大多数时候,人打开视频是想被带着走,不是想当编剧。
ACTx486 先拿一段已经做好的作品当底子,叙事、节奏、上下文都是现成的。你什么都不做,节目照常播;你想插一句,它就回应你,然后回到原来的轨道。团队把观众称为 「微导演」(microdirector):能改变自己关心的片刻,不必负责整部作品的走向。
为了让这种插话不出戏,很多细节都做得像视频本身的一部分:主持人的视线、说话的时机、语气、画面和转场。点一下屏幕,你可以提问、打断、顺着一个话题追问、让它生成画面、换一种语言,或者把信息发到你手机上,然后回到视频。
团队设想把这种方式用到更多视频中。比如看一节课时,你可以在没听懂的地方追问,让讲解跟着问题继续。这也是它比「给视频加个聊天框」更值得想象的地方:提问发生在原本的内容里,回答接得上你刚看到的画面。
它能做什么:12 段演示逐个看
主演示之外,还有 11 段短视频。逐段看,会发现系统做的事不只是回答问题:它还试着把回答画出来、让改动留在画面里,再接回原节目。
讲不清的,当场画给你看
需要图才能讲明白时,系统会生成一张示意图,让它随着讲解逐步出现。如果问题含糊,画面里的人还会先反问。
这段里,原节目中马斯克说他卖的喷火器「其实就是一把屋顶喷枪套了个气枪外壳」。Lia 说没听懂,AI 马斯克先问「哪里没听懂」,Lia 说是喷火器怎么工作;他就边说边画:丙烷罐接一根压力管,扣扳机开阀门,燃气从喷嘴出来,点火器在喷口点着。讲完,节目回到原片,乔接着问下一个问题。
它知道你是谁
系统里存着一份观众画像,所以同一个问题,不同的人会得到不同的答案。值得留下来的信息,会以卡片形式推送到你手机上,视频这边的对话不会停。
Lia 提到她大部分时间住在洛杉矶,问该去哪逛。AI 马斯克回答「当然是特斯拉餐厅(Tesla Diner)」,接着说会专门给她发几个地方,推荐就这么发到了她手机上。
你说什么语言,他就用什么语言答
每个主持人都能单独换语言。你用哪种语言问,他就用同一种语言答,声音和性格不变。两位主持人可以各说各的语言,而节目本身继续用原来的英语播。
Lia 用意大利语问该投 SpaceX 还是特斯拉,AI 马斯克也用意大利语回答,最后把选择留给她。Lia 说「换回英语」后,节目接着用英语播。语言只在这轮插话里切换,原片仍按原来的方式往下走。
只改一个瞬间
你可以只指挥一个动作,被改掉的那一刻前后,原来的对话照常进行。
原节目里有马斯克抽东西的著名片段。演示里,他在这一刻被指示不要抽,AI 马斯克回答「好,我不抽」;这一下改完,节目就回到原片,接着往下聊。
往画面里放一个东西,它会一直在
你可以往视频里加一个 3D 建模的物体,挪来挪去、继续跟它互动。中途打断再问别的,物体还停在你上次放的位置,每一轮追问都不会丢。
Lia 让马斯克把星舰拿出来讲讲,画面里出现一个 3D 模型。她接着让他打开外壳、讲里面的部件,最后让它「点火」。同一个模型跟着几轮提问变化,观众不用每次重新交代自己在看什么。
带你去另一个地方
还可以进入一个新的世界,把想法变成画面。这时原来的对话还在继续,保持原样、跟画面同步;你追问的内容会在这个新世界里加进新对白,结束后回到演播室。
Lia 插话说「带我去火星」,画面就从演播室换到火星,原节目那句关于未来的对话仍接着播放。她再追问火星上的生活,新的回答出现在这个场景里;这轮对话结束,画面回到演播室。
改动会累积,不会重置
Lia 先让乔戴上粉色毛耳朵,再让马斯克带大家去特斯拉工厂。场景换了,乔还穿着刚才那身粉色衣服。第二个请求沿用了第一个请求留下的画面状态,这比每次生成一段互不相干的新视频更接近连续对话。
两个人一起动,或者只对其中一个说
一个请求也能作用于整个场景。Lia 让两人「现在都跳上桌子」,他们便在同一个镜头里一起跳上桌;随后节目回到原片继续播放。
你也可以只对其中一个人说话:按住说话时,问题会交给那一刻画面里出现的人。在节目结尾,Lia 对乔说「结束之前亲埃隆一下」,画面里便生成了一个亲脸颊的动作。
把你自己放进画面
系统还可以用观众的摄像头,把观众本人放进画面。Lia 问「我能代替乔采访你吗」,接着她出现在演播室里,坐到乔的位置,向马斯克提问。观众不再只是在画面外发号施令,也能成为场景的一部分。
有些话不替真人说
Lia 问「埃隆,我该投票给谁」,AI 马斯克回答「这个问题有点棘手,有些话题我不能替真正的埃隆表态」,然后交还给原节目。
看着流畅,但现在还做不到实时
系统会分析请求、查资料、写回答,再生成场景,完整走完一次还要好几分钟。所以这 12 段视频都提前生成好了。它们展示了互动视频可能长什么样,尚不能让你边看边等它当场接话。
真人的脸和声音,谁来决定怎么用
这组演示未经马斯克和乔同意,就用他们的形象和声音生成新内容。最难分辨的不是哪一帧被改过,而是观众可能把合成台词当成真人表态。视频用 REAL 和 ARTIFICIAL 标签标明原片与生成片段的切换;如果这样的作品走出研究演示,标记和使用规则就会影响人们能否相信眼前的人真的说过什么。
演示里也有一道具体限制:当 Lia 问马斯克该投票给谁,模拟人物拒绝替真人回答。团队承认,现有做法还不足以处理所有以真人身份说话的情况。
还没想清楚的:控制权该归谁
ACTx486 让观众能在原有作品里插话,却也提出一个创作问题:一部视频的节奏、剪辑和留白本来由创作者决定。观众能改变的部分越多,作品原来的安排就越容易被改写。将来这种视频真正能用时,创作者愿意开放哪些部分,可能和生成能力本身一样重要。
看着视频,随时插一句
节目照常播放;你想追问或改变一个画面时,生成片段接上,结束后再回到原片。
ACTx486 用一段现成节目做底子。观众不必从空白处编剧情,只改自己关心的片刻。团队把这种观众称为「微导演」。
演示借用了《乔·罗根体验》中马斯克做嘉宾的一期节目。观众 Lia 点按画面提问,画面里的人回应;她不插话时,原节目继续播放。
它改变的不只是台词
问喷火器怎么工作,画面人物边解释边画图;让马斯克拿出星舰,模型会跟着几轮提问变化;说「带我去火星」,演播室画面换成火星,再接回原节目。
改动能留到下一轮。Lia 先给乔加上粉色装扮,再让大家去特斯拉工厂;换了场景,乔仍保留刚才的装扮。
现在能看到演示,还不能实时玩
这 12 段视频都提前生成好了。系统完整处理一次请求仍要好几分钟,所以片中流畅的插话,尚不是观众边看边等它当场接话。
看生成片段时,记住它借用了真人形象
画面里马斯克和乔的新台词并非本人所说。演示用标签区分原片与生成片段;问到该投票给谁时,模拟人物也拒绝替真人表态。