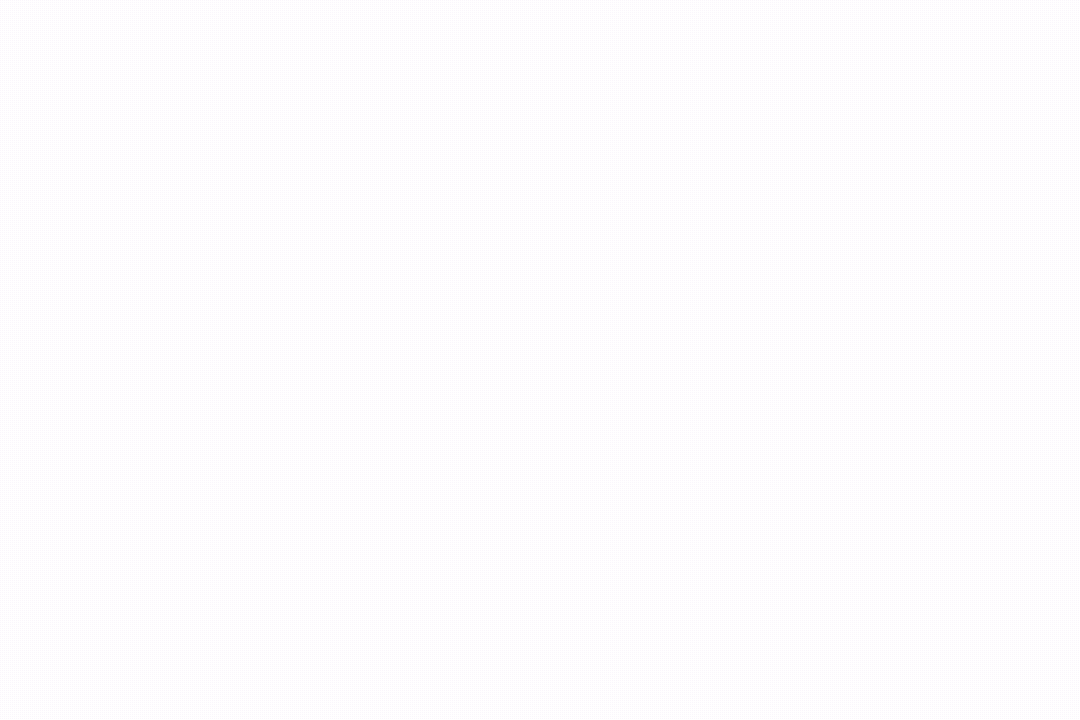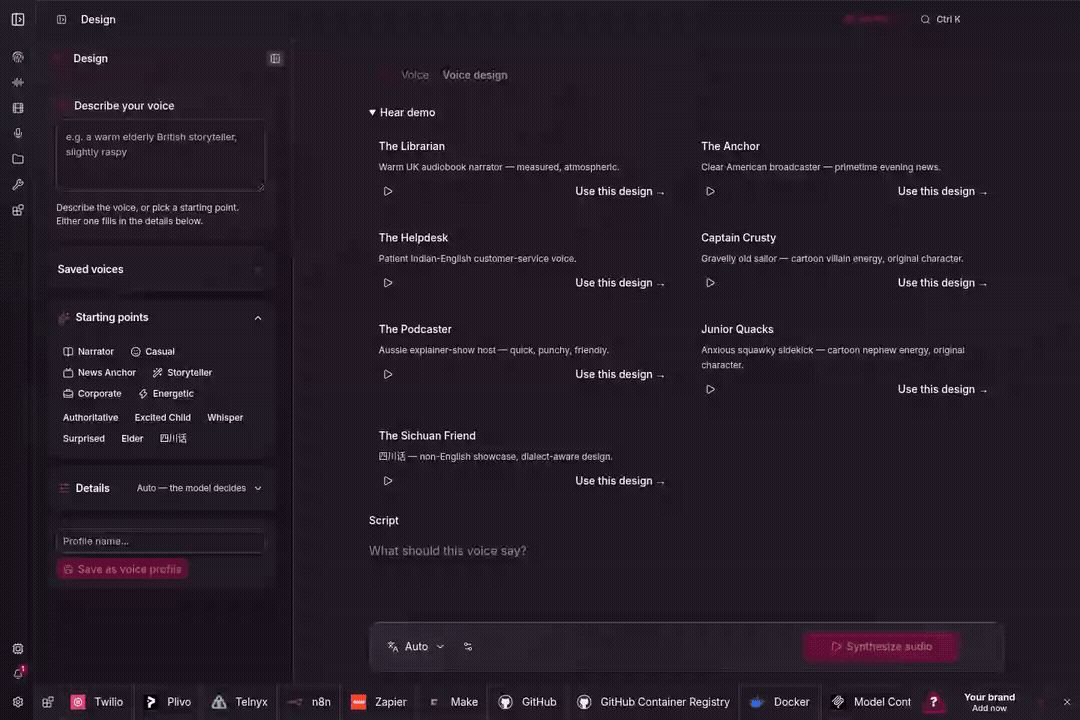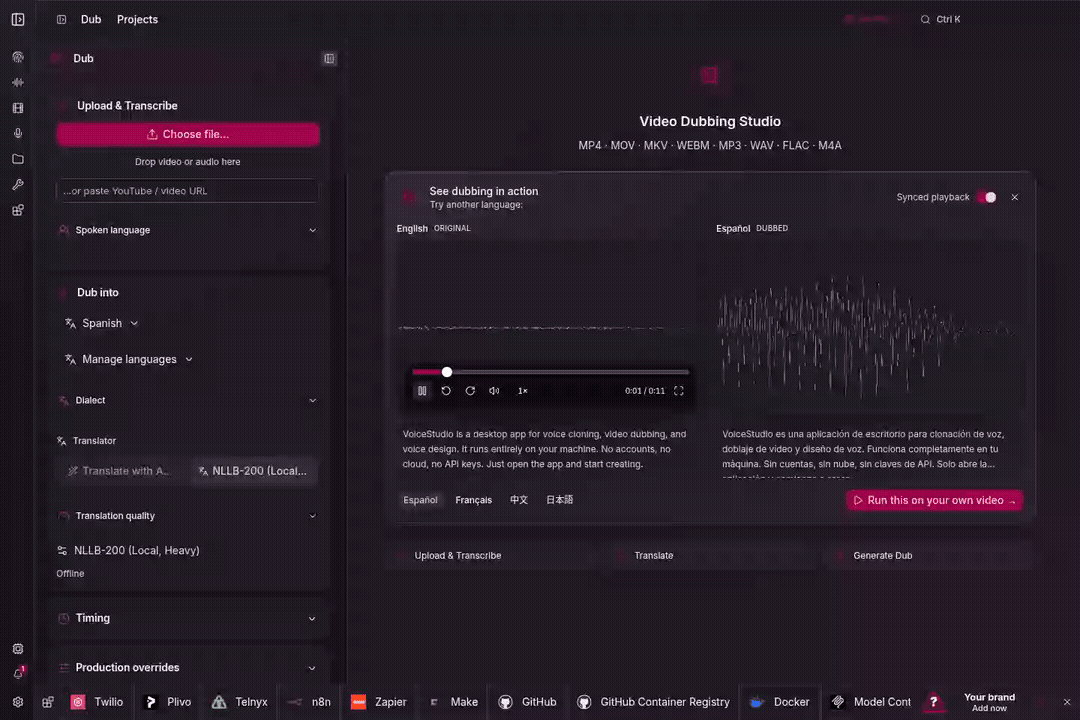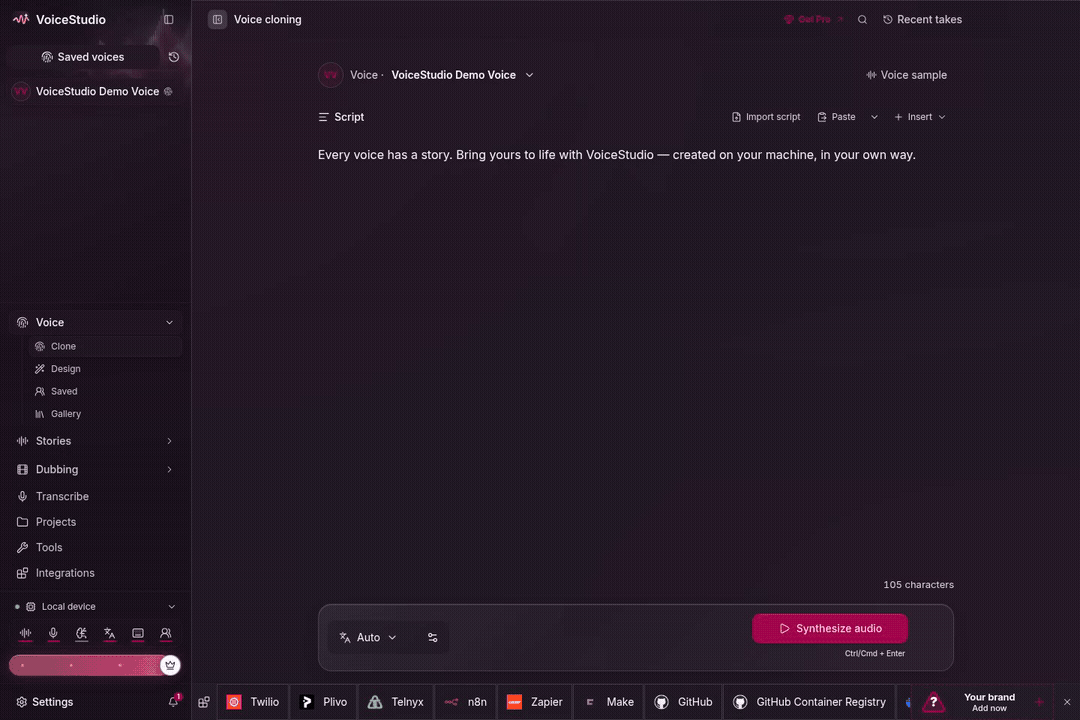
一、 为什么 VoiceStudio 能在 24 小时内引爆 GitHub?
VoiceStudio 的爆发并非偶然,它精准切中了当前 AI 开发者对于“数据隐私”与“推理成本”的双重痛点。不同于调用 ElevenLabs API,VoiceStudio 将音频合成、克隆、转录的全链路逻辑集成在本地,支持 646 种语言。
二、 架构剖析:VoiceStudio 的技术底座
从工程角度看,VoiceStudio 并非简单的模型封装,而是一套高度协同的音频处理流水线: - 推理引擎:基于优化后的 VITS/RVC 变体,针对不同语种的音素特征进行了特定量化。 - 转录模块:集成 Whisper-large-v3 的本地化蒸馏版本,保证了高并发下的低延迟。 - 模型权值管理:采用模块化加载机制,将模型权重与运行时逻辑解耦。
| 维度 | ElevenLabs (API) | VoiceStudio (Local) |
|---|---|---|
| 数据隐私 | 云端存储 | 完全本地 |
| 成本 | 按字符/分钟收费 | 一次性硬件投入 |
| 延迟 | 取决于网络 | 取决于本地显存带宽 |
| 自定义程度 | 受限 | 完全开源可修改 |
三、 环境搭建与生产部署实操
1. 硬件要求
- 显存:建议最低 8GB,推荐 12GB+ (RTX 3060/4070)
- 系统:Ubuntu 22.04 LTS 或 WSL2
2. 快速启动
# 克隆仓库
git clone https://github.com/debpalash/VoiceStudio
cd VoiceStudio

# 依赖安装
pip install -r requirements.txt

# 启动服务
python app.py --model_path ./weights --gpu_id 0
3. 参数调优建议
在 config.yaml 中,针对长音频任务,建议调整以下参数:
- chunk_size: 设置为 2048 以平衡显存占用与合成速度。
- sampling_rate: 设置为 44100 获取专业级音质。
四、 优缺点深度剖析
优点: - 完全离线:无需担心 API 封禁风险。 - 扩展性强:支持自定义微调模型接入。
缺点: - 模型冷启动:首次加载权重文件耗时较长。 - 硬件门槛:对显卡算力有刚性需求,移动端设备无法运行。